

Техническое обслуживание
Не замена картриджей — контроль инфраструктуры
Мы не сводим обслуживание к замене картриджей — хотя и это сделаем в рамках услуги, если нужно. Наша задача другая: быть на стороне вашей сети, инфраструктуры и корпоративных данных — замечать сбой раньше, чем он станет простоем, и закрывать инцидент до того, как о нём узнает смена.
Для этого мы создали продукт оперативного мониторинга и быстрого устранения неисправностей — программный комплекс LanMan. Он одинаково полезен небольшому заводу и корпорации с десятками филиалов.
Связь между филиалами и полный контроль сети
Во‑первых, обеспечиваем надёжную и безопасную связь между филиалами — от сегментации и VPN до контроля трафика на прикладном уровне. Во‑вторых, даём инструмент полного контроля над сетью, какой бы большой она ни была: сотни и тысячи узлов в одном контуре мониторинга.
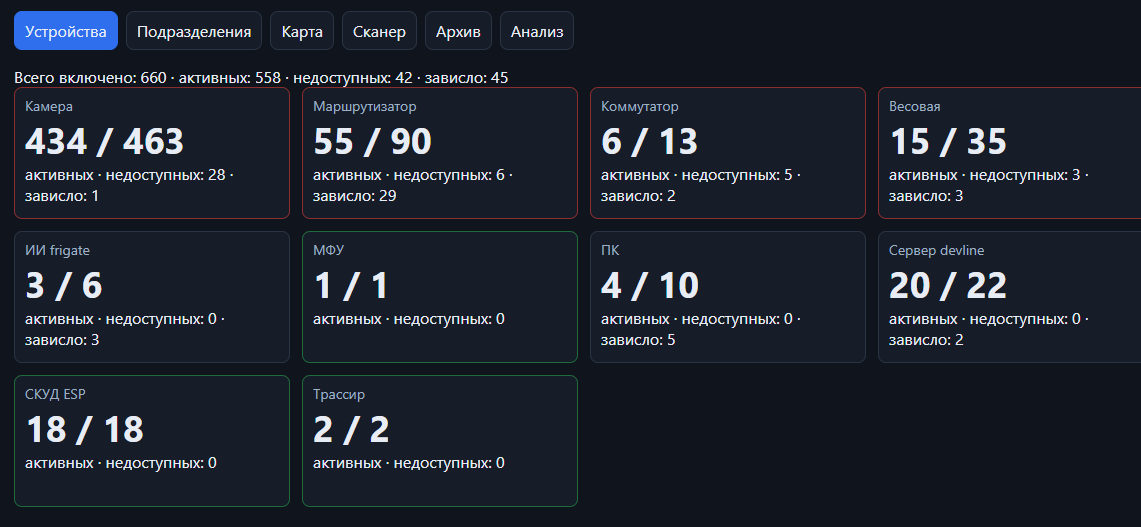
На сводке LanMan видно здоровье инфраструктуры целиком: камеры, маршрутизаторы, коммутаторы, весовые, серверы, СКУД и другое оборудование — сколько активно, сколько недоступно, где «зависло».
LanMan: онлайн-мониторинг и дисциплина реакции
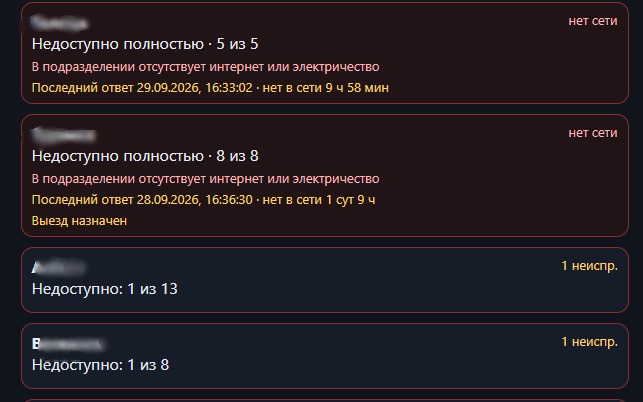
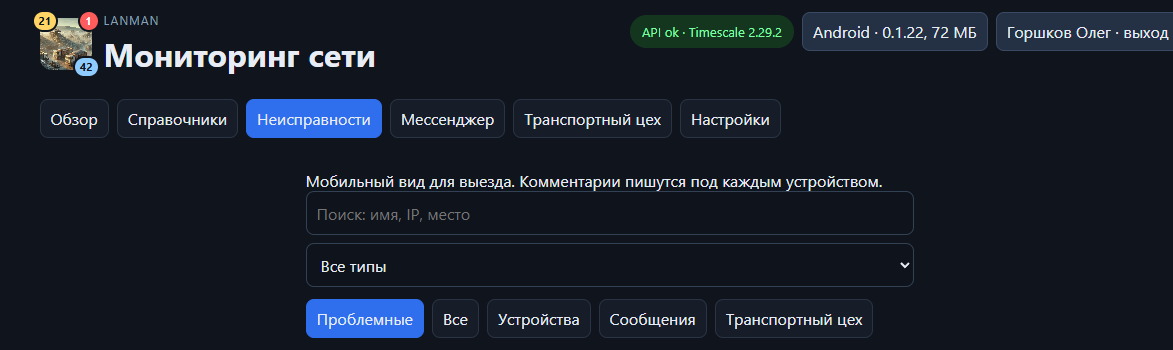
Комплекс в режиме онлайн следит за здоровьем инфраструктуры и контролирует, как быстро техники отрабатывают возникающие неисправности. По каждому событию фиксируется цепочка: обнаружение → назначение → выезд → закрытие.
- Единый экран проблемных объектов и устройств по всем площадкам
- Поиск по имени, IP и месту — удобно и в офисе, и в полевом мобильном виде
- Контроль времени реакции и статусов выезда («выезд назначен» и далее по факту)
- Комментарии под каждым устройством — контекст остаётся в системе, а не в чатах
Аналитика, которая учится на событиях
В LanMan есть аналитические модули, обучающиеся на истории инцидентов. Они предлагают вероятные причины неисправности — например, отсутствие интернета или электричества в подразделении, частичный отказ узла, «зависание» сервиса.
В итоге техник едет на объект не «просто посмотреть», а уже с рабочей гипотезой: что именно произошло и чем экипироваться. Это сокращает простой и число пустых выездов.
Что ещё входит в сопровождение
- Администрирование рабочих мест, серверов и базового ПО
- Сопровождение локальной сети и удалённых площадок
- Информационная безопасность и политика доступа
- Восстановление данных, консультации и оперативная помощь пользователям
- Wi‑Fi, IP‑телефония и смежные сервисы по мере необходимости
Подробнее по теме
Эволюция темы
Сопровождение ИТ на предприятиях долго сводилось к «приедет мастер после звонка»: картриджи, кабели, разовый ремонт. Когда сеть выросла до филиалов, камер, весовых и десятков узлов, реактивная модель стала дорогой: простой начинается раньше, чем приезжает техник. Современный контур — мониторинг, ранняя диагностика и полевой инструмент вроде LanMan: видеть деградацию до эскалации на смену, а не узнавать о ней от производства.
Аналитика темы
Стоимость владения инфраструктурой складывается не из прайса выезда, а из частоты сюрпризов и времени локализации. Без сводки устройств и вероятных причин техник тратит смену на поиск, а не на устранение. Сопровождение с мониторингом окупается там, где простой часа дороже месяца наблюдаемости — особенно при распределённых площадках и смешанном парке оборудования.
Расчёт эффективности
Оценочные ориентиры для площадки или сети филиалов с парком камер, сети, весовых и «зоопарком» узлов. Сравниваем «выезд по звонку» и сопровождение с мониторингом (LanMan).
Сокращение штата и выездов
Реактивная модель держит техника в разъездах и поиске «где умерло». Мониторинг с приоритезацией сокращает число выездов и время на объекте: ориентир 20–40% меньше выездов и/или высвобождение 0,3–0,8 ставки полевого инженера на сеть филиалов (условно 0,4–1,0 млн ₽/год) без ухудшения SLA — за счёт попадания в причину с первого раза.
Цена ошибок «узнали от смены»
- Простой сети / связи между филиалами: от десятков тыс. ₽/час потерянных операций и простоев смены
- Слепые камеры / СКУД / весовая «молчали сутки» — накопленный ущерб и разбор «кто виноват»
- Повторный выезд «не та причина» — двойная оплата полевых часов
Оценочно сокращение MTTR (время локализации и устранения) в 2–5 раз на критичных узлах за год часто перекрывает стоимость наблюдаемости и абонентского контура.
Время принятия решения
От звонка «у нас опять ничего не работает» (минуты–часы на понимание где) к сводке: узел, вероятные причины, приоритет выезда — решение за минуты. Руководство видит не хаос тикетов, а управляемый backlog инфраструктуры.
Инвестиционная привлекательность
Когда час простоя дороже месяца сопровождения, ROI очевиден: типичный payback 3–12 месяцев на объектах с ценой простоя от ~50–100 тыс. ₽/час и регулярными инцидентами. Для инвестора в цифровизацию стабильная инфраструктура — условие любых MES/IIoT/видео-проектов; иначе цифровые контуры «падают» вместе с сетью. Усиление — на странице сетевой безопасности.
Чем сопровождение инфраструктуры отличается от «выезда по звонку»
Реактивный подрядчик узнаёт о проблеме от смены — когда простой уже начался. Наша модель другая: мониторинг сети и узлов, ранние признаки деградации, понятная цепочка «заметили → локализовали → устранили» до эскалации на производство. LanMan как раз для этого: сводка устройств, вероятные причины, полевой вид для выезда техника.
Что обычно входит в контур
- Связь между филиалами и сегментация без «дыр ради удобства»
- Контроль камер, маршрутизаторов, коммутаторов, весовых и смежных узлов
- Аналитика неисправностей и приоритезация выездов
- При необходимости — бытовые работы вроде картриджей, но не вместо контроля сети
Масштаб одинаково полезен небольшому заводу и сети филиалов: один инструмент видения вместо разрозненных звонков «у нас снова пропал интернет». Усиление сетевой безопасности обсуждаем на странице сетевой безопасности.